


Час від часу, коли новий набір відкритих ваг випадає для нової моделі, я поспішаю на сцену, щоб побачити, на що вона здатна. Нещодавно це сталося, коли Qwen3.8-27B прибув у серпні, і, ймовірно, це станеться знову, коли Alibaba або Google надішле щось, що приверне мою увагу.
Іноді мене засмучує те, що відбувається після завантаження. Я запускаю моделі на своїй RTX 4070 Ti Super, як очікувалося, але іноді моделі можуть повзати, просочуватися з відеопам’яті в системну пам’ять або іншим чином не погоджуватися з моєю машиною. Після того, як це сталося кілька разів, я склав уявний список цифр, на які потрібно звернутись перед масовим завантаженням.
Ось чотири цифри, які я читаю щоразу, і шкода, що я почав кілька місяців тому.
КВ-кеш
Обліковий запис пам’яті, який, здається, нікому не цікавий

Більшість нових місцевих ентузіастів штучного інтелекту просто дивляться на вагу моделі, перш ніж спробувати нову модель, як я робив більшу частину минулого року. Зрештою, якщо ваги відповідають VRAM, навіть якщо вони точно збігаються, модель має працювати, чи не так?
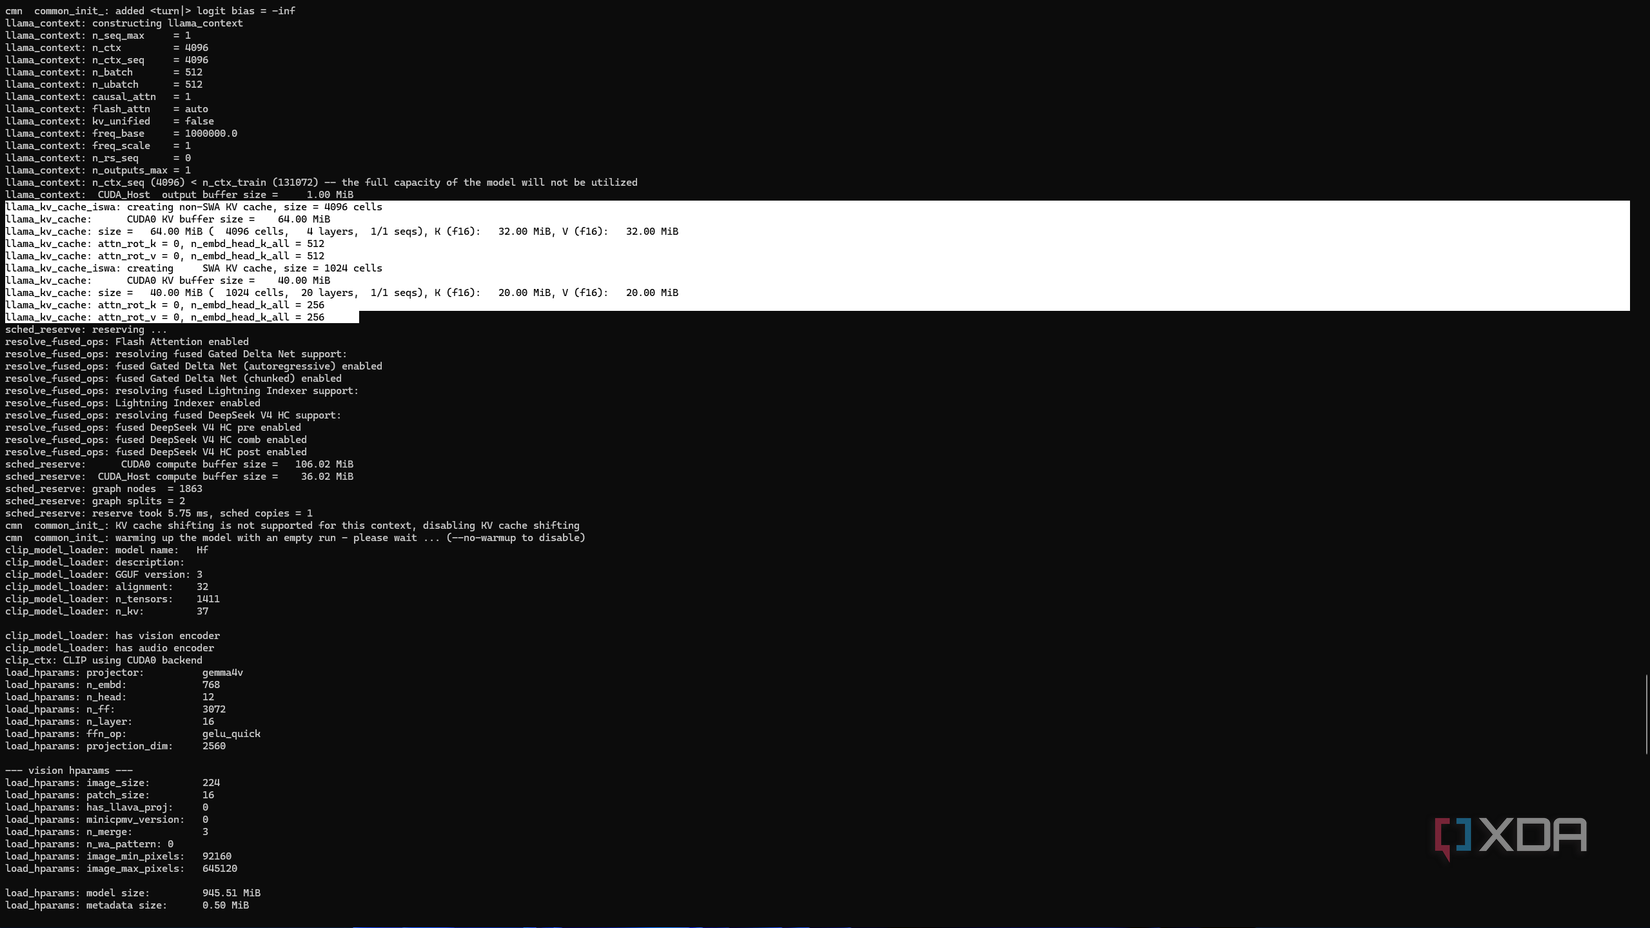
Ну, начебто. Проблема в тому, що вага — це не єдине, що з’їдає вашу VRAM. Існує також кеш KV, який є обліковим записом пам’яті моделі для всього, що ви тримаєте під час поточної розмови. На відміну від ваг, цей рахунок збільшується пропорційно контексту.
На моїй RTX 4070 Ti Super модель 14B у четвертому кварталі мала в середньому близько 7 ГБ пам’яті, що звучало досить добре, поки я не вирішив збільшити вікно контексту до 32 КБ. Кілька гігабайт можуть зникнути лише в кеші, і, можливо, навіть більше, якщо модель використовує повну багатошляховість замість групування запитів.
Модель завантажується, запускається, а потім, коли ви вставляєте довгий документ, швидкість візуалізації сповільнюється, оскільки це спричиняє витік відеопам’яті. Важливо врахувати ці накладні витрати та перевірити, якщо можливо, чи середовище виконання підтримує квантування кешу, оскільки відкидання кешу до Q8 зменшить вартість приблизно вдвічі.
Точна кількість
Чотири біти – це не число, це більше схоже на сім’ю

Однією з фраз, яку я часто бачив у місцевому ландшафті штучного інтелекту, на форумах і в субредітах загалом, є «квантова версія», у якій я завжди був одним із найменш освічених. Усі Q4_K_M, Q4_0 та IQ4_XS є 4-бітними, але вони відрізняються бітами за вагою, втратою удару та розміром.
Перехід із Q4 на Q8 подвоює заряд відеопам’яті за тих самих ваг. На моїй скромній карті на 16 ГБ це часто може звести нанівець різницю між моделлю 24B у Q4_K_M, що завантажується з достатнім простором для кешу KV, і тією самою моделлю Q8_0, яка ідеально відповідає та сканує.
Суфікс також несе інформацію, і я думаю, що для звичайного користувача він такий же важливий, як і число. K-кванти зберігають шари, найбільш чутливі до втрати точності, на більшій глибині та стискають решту, тому Q4_K_M поводиться краще, ніж плоский Q4_0 такого ж розміру. Саме з цієї причини я звик читати всю назву файлу, коли кажу про кількість.
Активні параметри
Скільки активних? Скільки їх на тарілці? Не те саме

Довгий час після того, як вага впала, я вважав, що Gemma 4 E4B — це модель 4B. Це точно ні, і це було дуже незручно, коли я дізнався. Буква «E» в номенклатурі означає ефективний, а не активний, а E4B має близько 4,5 B ефективних параметрів разом із приблизно 8 B після врахування розміщення кожного шару. Саме ця прогалина змусила мене правильно прочитати мітки параметрів.
Змішані експертні моделі (ME) породжують таку ж плутанину, хоча й з протилежного напрямку. Якщо ви подивитеся на Qwen 30B-A3B, кожен сигнал маршрутизується через активні параметри близько 3B, тому він здатний виробляти зі швидкістю маленької моделі, тоді як усі ваги 30B все ще повинні десь жити.
Коли ви, як я, живете на 16 ГБ відеопам’яті, це дещо ускладнює роботу. Наприклад, модель віртуальної машини класу 30B у четвертому кварталі може отримати 16-18 ГБ перед кеш-пам’яттю, тому вона не буде на 100% резидентною у VRAM, хоча поводиться як модель 3B, коли йдеться про швидкість. Моделі віртуальних машин зазвичай мають кращу толерантність до навантаження на процесор, ніж компактні моделі, але все одно варто пам’ятати про активні параметри.
Контекст рідного навчання
Часто це потужне число

Інша річ, у якій я був винний у місцевих оглядах AI, це надто буквальне сприйняття довжини контексту. Якби в документації моделі було вказано, що вона підтримує 128K, я б припустив, що міг би написати про неї повний роман і очікувати, що вона запам’ятає все, що там було. Виявляється, «підтримується 128 КБ» і «навчається 128 КБ» означають різні речі. Багато з цих вікон отримано шляхом масштабування позиції обертання після попереднього навчання або їх розтягування за допомогою YaRN, тоді як сама модель тренується на чомусь набагато коротшому.
Мабуть, найцікавіша частина полягає в тому, що сама модель не виявляє жодних ознак несправності, коли ви штовхаєте її за початкову довжину. Це просто тихо, поступово погіршується, коли ви щось знаходите, і коли справа доходить до місцевих моделей, вони все одно так раді дати вам відповідь, що важко зрозуміти, чи відповідь звучить правильно. Немає сенсу витрачати VRAM на кеш-пам’ять розміром 128 КБ, якщо сама модель стає ненадійною приблизно на 32 КБ.
Кнопка завантаження з’явиться після того, як ви все це обчислите
Пам’ятаючи про ці чотири цифри та п’ять хвилин, можна значно заощадити пропускну здатність для будь-кого, хто новачок у місцевій сцені штучного інтелекту. Я вважаю, що багато з цих аспектів погано вивчені в більшості онлайн-посібників, де йдеться лише про початкове налаштування і нічого після цього, що часто може призвести до поганого досвіду для тих, хто працює з хмарними моделями.

